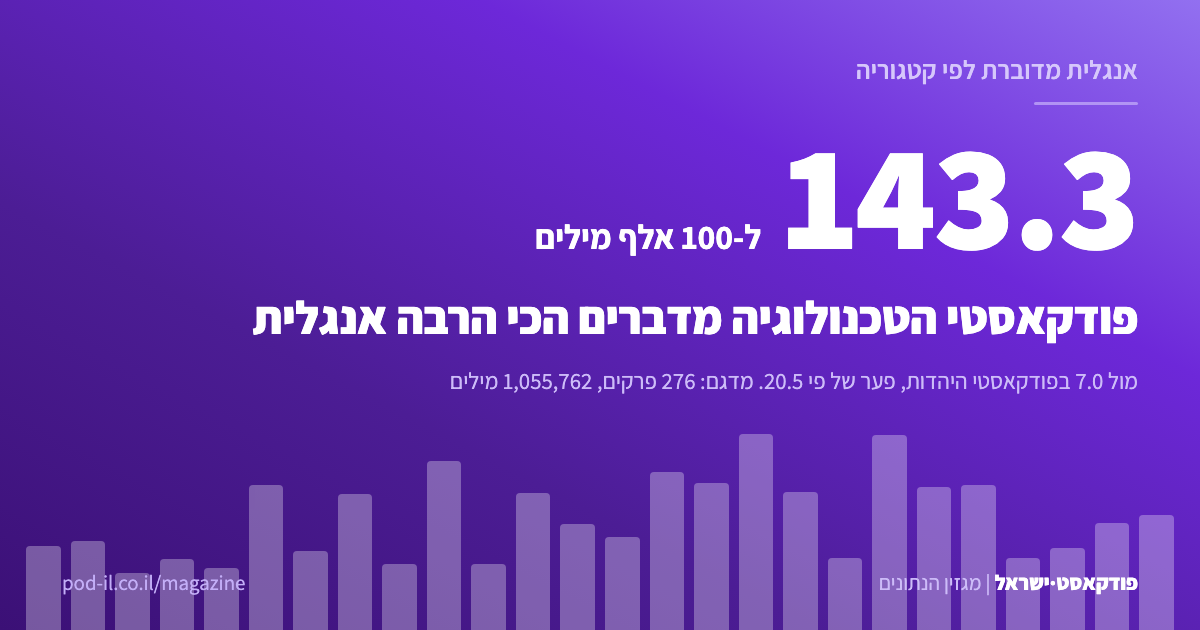
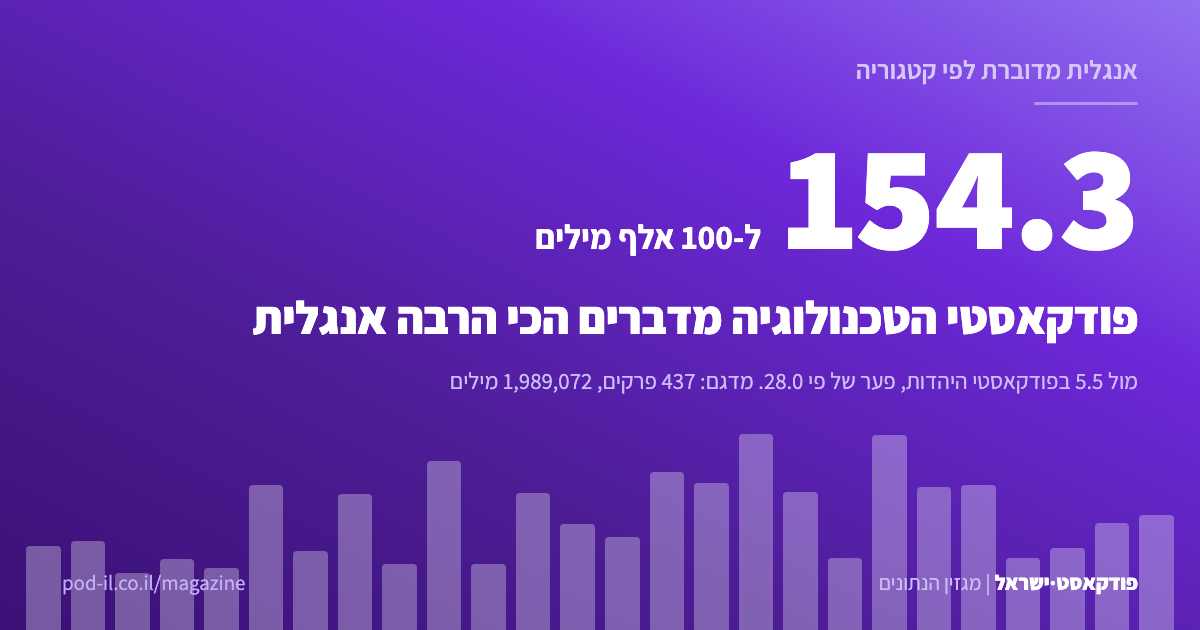
20,468 פעמים נאמרה מילה אנגלית מתועתקת בתוך משפט עברי, ב-15,094 תמלילים של פודקאסטים ישראליים ובסך הכול 70,660,609 מילים. זו מילה לועזית אחת לכל 3,452 מילים מדוברות. אבל הפיזור לא אחיד: בפודקאסטי הטכנולוגיה הצפיפות היא 154.3 אזכורים לכל 100 אלף מילים, ובפודקאסטי היהדות 5.5 בלבד, פער של פי 28.0.
מה נמדד כאן, ובמה זה שונה ממדידת שמות התוכניות
המדידה הזו נעשתה על התמלילים עצמם, כלומר על המילים שנאמרו בפרקים, ולא על מה שכתוב בכותרת. בסיס הנתונים: 15,094 תמלילים קנוניים של פרקים, מ-2,612 תוכניות שונות, 70,660,609 מילים. 14,918 מהתמלילים שייכים לתוכנית שעדיין נמצאת באינדקס של 3,541 התוכניות, ו-176 שייכים לתוכניות שיצאו ממנו מאז.
חשוב להפריד את זה ממדידה קודמת שפורסמה כאן. הכתבה על האנגלית בשמות הפודקאסטים הישראליים ספרה שמות תוכניות שמכילים מילה באותיות לטיניות. זו מדידה אחרת לגמרי: יחידת הספירה שם היא שם תוכנית, כאן היא מילה מדוברת. שתי המדידות לא מתחרות זו בזו ולא מאששות זו את זו, ואי אפשר להשוות ביניהן ישירות.
שיטת הזיהוי היא ביטוי רגולרי עם גבול מילה עברי, ולא חיפוש מחרוזת פשוט. חיפוש מחרוזת בעברית משקר: המילה "דיל" נתפסת בתוך "להבדיל", והמילה "באג" נתפסת בתוך "באג'נדה" ובתוך "באג"ח" אם לא חוסמים גם את הגרש והגרשיים. בבדיקה שלנו, חסימת הגרש לבדה הורידה את "באג" מ-630 אזכורים ל-305, כלומר יותר ממחצית מהתוצאות היו שגויות.
25 המילים שנספרו, ואחת שלא עברה את הסף
נבחנו 26 מילים לועזיות, ולכל אחת מהן רשמנו חלופה עברית. 25 מהן עברו את סף הפרסום שלנו של 30 פרקים לפחות. רק אחת לא עברה אותו ולכן היא לא נכללת בהשוואות: בוטום ליין (17 פרקים). היא נמדדה והיא קיימת, אבל המדגם קטן מדי להשוואה.
כל הספירות הן של צורת הבסיס בלבד. "טרנדים" ו"באגים" לא נספרים, כי הגבול העברי חוסם כל סיומת. המשמעות המעשית: כל מספר בטבלה הזו הוא רצפה ולא תקרה, והמספר האמיתי גבוה יותר.
25 המילים, לפי מספר הפרקים שבהם נאמרו
מדגם: 15,094 תמלילים, 70,660,609 מילים. רחפו מעל עמודה כדי לראות את שלושת המספרים של אותה מילה.
מקור: scripts/mag_hebrew-podcast-spoken-anglicisms.py על data/transcripts/*__epN.txt (15,094 תמלילים) ועל data/podcasts.json.
שתי משפחות נפרדות מסתתרות בטבלה. תשע מילים סווגו אצלנו כשאילות ותיקות (פלטפורמה, קונספט, ביזנס, פוקוס, טרנד, ברנד, אקזיט, סטארטאפ, באג), והן אחראיות ל-11,553 מהאזכורים. שש עשרה מילים סווגו כהחלפת קוד גולמית, כלומר מילה אנגלית שנאמרת כמו שהיא בתוך משפט עברי (קונטקסט, פידבק, אימפקט, ליטרלי, מיינדסט, סקייל, פרודקט, טיימינג, פרפורמנס, אינפוט, דדליין, סטייטמנט, אינסייט, פייפליין, אאוטפוט, בייסיקלי), והן אחראיות ל-8,915 אזכורים. יחד, 20,468 אזכורים בקורפוס של 15,094 תמלילים.
המילה שנאמרת בהכי הרבה פרקים היא קונספט: 1,141 פרקים ו-602 תוכניות שונות, 1,888 פעמים. צמוד אליה פלטפורמה, עם 1,131 פרקים ו-596 תוכניות, אבל בספירת האזכורים היא מובילה בפער, 2,335 פעמים. שלישית ביזנס (996 פרקים, 2,087 אזכורים, 498 תוכניות). בסך הכול, 5,546 מתוך 15,094 הפרקים בקורפוס, 36.7%, מכילים לפחות אחת מ-26 המילים שנבחנו.
שלוש מילים נפסלו לפני הספירה, וחשוב לומר למה. "דיל" נפסלה כי הביטוי נתפס בתוך "להבדיל". "אלגוריתם" נפסלה כי היא לא שאילה מאנגלית והיא המונח העברי התקני, כלומר אין ממה להחליף. "אקטואלי" נפסלה כי היא הגיעה לעברית דרך הגרמנית והרוסית ולא דרך האנגלית. בנוסף, 69 מופעים של "הוקוס פוקוס" הוחסרו מהספירה של "פוקוס", ושני מופעים של שם הקרן "אינסייט פרטנרס" הוחסרו מהספירה של "אינסייט".
הפער בין הקטגוריות הוא הממצא האמיתי
ממוצע הקורפוס כולו הוא 29.1 אזכורים לכל 100 אלף מילים (20,411 אזכורים על פני 70,039,168 מילים בתוכניות שעדיין באינדקס). מסביב לממוצע הזה נפרש טווח עצום. בחרו קטגוריה כדי לראות את המספרים שלה.
כמה אנגלית מדוברת יש בקטגוריה שלכם
| קטגוריה | פרקים | מילים | לועזיות ל-100 אלף | % פרקים עם לועזית |
|---|---|---|---|---|
| טכנולוגיה | 437 | 1,989,072 | 154.3 | 77.3% |
| עסקים | 837 | 3,483,771 | 76.1 | 53.9% |
| בריאות | 219 | 917,784 | 33.0 | 48.9% |
| בידור | 207 | 787,202 | 24.8 | 36.2% |
| כללי | 9,163 | 39,929,257 | 24.2 | 33.6% |
| תרבות | 1,424 | 8,258,985 | 23.6 | 42.0% |
| קומדיה | 457 | 4,226,256 | 21.7 | 60.2% |
| תעלומות פשע | 103 | 634,044 | 19.4 | 54.4% |
| מדע | 319 | 1,561,564 | 18.3 | 34.2% |
| הורות | 134 | 479,918 | 17.9 | 21.6% |
| חינוך | 897 | 4,890,532 | 16.7 | 26.5% |
| חדשות | 280 | 1,294,264 | 16.5 | 29.3% |
| היסטוריה | 266 | 843,543 | 10.9 | 17.7% |
| יהדות | 175 | 742,976 | 5.5 | 13.7% |
כל הקטגוריות באינדקס עברו את סף 30 הפרקים, ולכן אף אחת מהן לא הושמטה. מקור: scripts/mag_hebrew-podcast-spoken-anglicisms.py.
הקצה העליון הוא טכנולוגיה, 154.3 אזכורים ל-100 אלף מילים על פני 437 פרקים, ואחריו עסקים, 76.1 על פני 837 פרקים. הקצה התחתון הוא יהדות, 5.5 על פני 175 פרקים, ולפניה היסטוריה, 10.9 על פני 266 פרקים. היחס בין הקצוות הוא פי 28.0. גם שיעור הפרקים שמכילים לפחות מילה אחת נע באותו כיוון בקצוות: 77.3% בטכנולוגיה מול 13.7% ביהדות.
ברמת התוכנית הבודדת הפער חד עוד יותר, אבל כאן צריך זהירות. רק 26 תוכניות בקורפוס מגיעות ל-30 תמלילים או יותר, ולכן רק עליהן מותר לומר משהו. הצפופה מביניהן היא מבט לאחור, תוכנית עסקים עם 160.0 אזכורים ל-100 אלף מילים על פני 56 פרקים ו-652,583 מילים. בתחתית אותן 26 תוכניות יש תוכניות שנעות בין 5.9 ל-7.1 אזכורים ל-100 אלף, ביניהן גדי טאוב: שומר סף.
איך זה נשמע בתוך משפט אמיתי
הדיאגרמה למטה לוקחת שני משפטים אמיתיים מהתמלילים, אחד מתוכנית טכנולוגיה ואחד מתוכנית תרבות, ומראה את המנגנון: איזו מילה הושאלה, מה החלופה העברית שלה, וכמה פרקים אומרים אותה. אפשר להחליף בין המשפטים ולפתוח כל מילה מסומנת.
מנגנון ההשאלה, בשני משפטים אמיתיים
ברנדים גדולים, קודם כל, מי שקם בבוקר להקים ברנד גדול משמעותי, המיינדסט שלו הוא טיפה אחר, הרבה חושבים על זה בצורה אחרת, הם מגיעים עם הפנדינג הנכון, הם מגיעים עם המיינדסט הנכון.
זאת אומרת, אנחנו לא רק מקבלים, ואז יש כמו מחשב, מקבל אינפוט ואז שולח אאוטפוט.
- המילים מתרכזות בתחומים. בנתונים רואים שהמילים האלה מתרכזות בתחומים מסוימים: טכנולוגיה עומדת על 154.3 אזכורים ל-100 אלף מילים ויהדות על 5.5.
- בדיבור הן נפוצות. בדיבור ספונטני בדרך כלל אין עורך לשון. 5,546 מתוך 15,094 הפרקים, 36.7%, מכילים לפחות אחת מ-26 המילים שנבחנו.
- הספירה תופסת רק חלק. צורות עם סיומת עברית, כמו ברנדים או באגים, לא נספרות כאן בכלל. לכן כל מספר בכתבה הוא רצפה, והשימוש האמיתי רחב יותר.
- בלי תמלול, המילה נשארת באודיו. "מיינדסט" נאמרה ב-390 פרקים. בלי טקסט של הפרק, המילה הזו קיימת רק באודיו.
הציטוטים הועתקו מהתמלילים כלשונם, כשרצפי רווחים כווצו לרווח יחיד. מקור: scripts/mag_hebrew-podcast-spoken-anglicisms.py.
המשפט המדגים הכי טוב את הפער נמצא דווקא בתוכנית הצפופה ביותר מבין 26 התוכניות שעברו את הסף, מבט לאחור, שבה נאמרו המילה העברית והמילה האנגלית באותו משפט ממש: "עסק שמכניס כסף, זאת אומרת, זה ביזנס אמיתי, והוא מכניס כסף, רק שלפחות במדינת ישראל, כמות הכסף שתוכל להכניס מעסק יכולה להיות מאוד יפה ויכול להיות סכומים מאוד מאוד יפים, אבל זה לא יתקרב לאקזיט של יזם." בתוכנית כושר ניהול זה נשמע כך: "זה יכול להספיק לי, אבל אם אתה בונה ביזנס שהוא בסקייל יחסית גבוה, מדבר להמון קהלים, אתה צריך למצוא את הדרך, לא יעזור." ובתוכנית Product Builder | פרודקט בילדר במשפט קצר אחד: "ולהבין רגע על מה אני שם הפוקוס ואיך אני עושה אימפקט."
האנגלית באותיות לטיניות היא סיפור אחר לגמרי
לצד המילים המתועתקות ספרנו גם כמה מהמילים בקורפוס מכילות בכלל אות לטינית. התשובה: 947,031 מתוך 70,660,609, כלומר 1.34%. זה נשמע כמו מספר קטן, והוא באמת קטן, אבל הוא גם מטעה, כי הוא לא מפוזר.
הפרק החציוני בקורפוס מכיל 0.10% מילים עם אות לטינית, כלומר כמעט אפס (מדגם: 15,094 פרקים). 4,736 פרקים לא מכילים ולו מילה אחת עם אות לטינית. ובקצה השני, 213 פרקים בלבד, 1.4% מהקורפוס, מורכבים ב-20% ומעלה ממילים לטיניות, והם לבדם מחזיקים 66.8% מכל המילים הלטיניות בקורפוס כולו. במילים אחרות: שני שלישים מהמילים באותיות לטיניות בתמלילים מרוכזים בפרקים שבהם 20% ומעלה מהמילים לטיניות, ולא מפוזרים באופן שווה בקורפוס.
ערבוב בתוך מילה אחת הוא תופעה קטנה בהרבה: 54,383 מילים בקורפוס, 0.077%, מערבבות עברית ולטינית בתוך אותה מילה אחת. הבולטות שבהן הן צורות שבהן תחילית עברית נדבקת לראשי תיבות אנגליים. הצורה הנפוצה ביותר היא "ה-AI" עם 4,125 מופעים, אחריה "ב-AI" עם 1,696, "ה-DNA" עם 772 ו"ל-AI" עם 722. זו החלפת קוד במובן המובהק ביותר שאפשר למדוד: מורפולוגיה עברית על גבי מילה אנגלית.
גם צפיפות האותיות הלטיניות משתנה לפי קטגוריה. בראש עומדת שוב טכנולוגיה, 21.8 מילים לטיניות לכל 1,000 מילים על פני 437 פרקים. הדלילה ביותר היא הורות, 1.3 לכל 1,000 על פני 134 פרקים, פער של פי 16.5. אבל מתחת לראש הסדר מתפצל: תרבות היא השנייה באותיות לטיניות, 18.8 לכל 1,000, ורק השישית במילים המתועתקות. העובדה ששני הדירוגים אינם זהים היא בדיוק העניין: מילה לועזית שנאמרת ומילה לועזית שנכתבת אינן אותה תופעה.
מה זה אומר למי שמפיק פודקאסט
המסקנה המעשית פשוטה, והיא נובעת ישירות מהמספרים. בקטגוריות טכנולוגיה ועסקים מדדנו צפיפות ממוצעת של 154.3 ו-76.1 מילים לועזיות לכל 100 אלף מילים. אלה ממוצעים של הקטגוריה כולה, לא של כל תוכנית. ההמלצה שלנו: לפרסם לצד כל פרק תמליל או סיכום, כי מנוע חיפוש או מודל שפה שקוראים טקסט מגיעים בקלות רבה יותר למה שנאמר בפרק כשהוא כתוב.
וההפך נכון גם הוא. בקטגוריות יהדות והיסטוריה הצפיפות הממוצעת היא 5.5 עד 10.9, כלומר המילים מהרשימה נדירות שם בהרבה. גם שם כדאי לבדוק קודם את הנראות, לא את השפה.
שני המצבים מצביעים על אותו פתרון. בלי טקסט לצד הפרק, קשה יותר לחיפוש ולכלים שקוראים טקסט למצוא משפט מתוכו ולצטט אותו. הכתבה הזו עצמה נכתבה על גבי תמלילים, וזה בדיוק המנגנון שהופך ארכיון אודיו למאגר שאפשר לצטט. איך זה עובד בעמוד היוצרים.
שאלות ותשובות
כמה מילים אנגליות באמת נאמרות בפודקאסטים הישראליים?
20,468 אזכורים של 25 מילים אנגליות מתועתקות, ב-15,094 תמלילים שמכילים 70,660,609 מילים. זו מילה אחת לכל 3,452 מילים מדוברות, 0.029% מכלל המילים.
איזו מילה אנגלית נאמרת הכי הרבה?
תלוי איך סופרים. בספירת אזכורים מובילה "פלטפורמה", 2,335 פעמים ב-1,131 פרקים. בספירת פרקים מובילה "קונספט", שנאמרה ב-1,141 פרקים ו-602 תוכניות שונות. שלישית "ביזנס" (996 פרקים).
אילו פודקאסטים מדברים הכי הרבה אנגלית?
פודקאסטי טכנולוגיה, 154.3 אזכורים לכל 100 אלף מילים על פני 437 פרקים, ואחריהם פודקאסטי עסקים, 76.1 על פני 837 פרקים. הכי מעט: פודקאסטי יהדות, 5.5 על פני 175 פרקים.
האם זה אותו ממצא כמו האנגלית בשמות התוכניות?
לא. המדידה של שמות התוכניות ספרה שמות עם מילה באותיות לטיניות. זו יחידת ספירה אחרת (שם תוכנית מול מילה מדוברת) ומקור נתונים אחר (data/podcasts.json מול התמלילים), ולכן אי אפשר להשוות בין שתי המדידות.
איך חישבנו: corpus_query = scripts/mag_hebrew-podcast-spoken-anglicisms.py, שרץ משורש המאגר בלי ארגומנטים. נספרו רק תמלילים קנוניים, כלומר כל data/transcripts/*.txt ששמו תואם __epN.txt, ולא כפילויות iCloud מסוג "__epN 2.txt". המילים הלועזיות זוהו בביטוי רגולרי עם גבול עברי ותחילית אחת אופציונלית מתוך והבלמכש, כשגם גרש וגרשיים חוסמים את הגבול. נספרה צורת הבסיס בלבד, ולכן כל מספר הוא רצפה. הקטגוריה נלקחה מ-data/podcasts.json לפי שם הקובץ. אף שדה שנוצר בבינה מלאכותית לא שימש כאן: הספירה נעשתה על התמלילים הגולמיים בלבד. צילום המצב: 11 באוקטובר 2026, 15,094 תמלילים. הקורפוס גדל מדי יום, ולכן הרצה מאוחרת יותר תחזיר מספרים אחרים.
הכתבה נכתבה בסיוע בינה מלאכותית על בסיס ניתוח הקורפוס של פודקאסט·ישראל. כל המספרים חושבו מחדש מהנתונים בזמן הכתיבה וניתנים לשחזור דרך הסקריפט הנקוב למעלה ודרך עמוד המתודולוגיה.