44.7% מהפרקים הישראליים כוללים ברכה מדוברת בפתיחה, 6,744 מתוך 15,094 תמלולים, ב-1,000 התווים הראשונים של התמלול. כמעט רבע מכלל הפרקים, 3,759 במספר, אומרים את אותן שתי מילים בדיוק: ברוכים הבאים. מי שמאזין שומע אותן בתחילת הפרק, ומנוע חיפוש שקורא רק טקסט לא שומע אותן בכלל.
איך חושב: כל המספרים כאן חושבו מחדש בזמן הכתיבה על ידי scripts/mag_israeli-podcast-openings.py, שרץ על כל התמלולים הקנוניים ב-data/transcripts (כל קובץ שסופו __ep ומספר), ומחפש עשר נוסחאות ברכה בעברית בעזרת ביטוי רגולרי עם גבול מילה עברי ואות שימוש אופציונלית. מאפייני התוכנית מגיעים מ-data/podcasts.json, וקצב הדיבור מקבצי הלוואי של התמלולים. שיטת העבודה של האתר מפורטת בעמוד המתודולוגיה, ונתוני השוק המלאים בעמוד הסטטיסטיקות. הערה אחת על היציבות: הקורפוס ממשיך לגדול, ולכן כל המספרים כאן הם תצלום מצב נכון ל-11 באוקטובר 2026, של N = 15,094 תמלולים.
עשר נוסחאות, אחת שולטת
סרקנו את 1,000 התווים הראשונים של כל פרק וחיפשנו עשר נוסחאות ברכה מדוברות. התוצאה אינה מפוזרת: נוסחה אחת לבדה מופיעה ביותר פרקים מכל שלוש הנוסחאות שאחריה יחד.
עשר נוסחאות הפתיחה, לפי מספר הפרקים
N = 15,094 פרקים. סכום העמודות גדול מ-6,744 כי פרק אחד יכול לומר יותר מנוסחה אחת.
מקור: scripts/mag_israeli-podcast-openings.py, 1,000 התווים הראשונים של כל תמלול קנוני ב-data/transcripts
שימו לב לפער בין המקום הראשון לשני. ברוכים הבאים מופיעה ב-3,759 פרקים, שלום לכולם ב-1,208 בלבד, ובוקר טוב ב-1,070. כשכמעט רבע מכל הפרקים במאגר אומרים בפתיחה את אותן שתי מילים, המילים האלה כבר לא מבדילות פרק אחד מאחר. הן רעש רקע.
כך זה נשמע בפועל. בפרק 359 של Lets Talk Murder, בואי נדבר רצח, אחד מ-364 הפרקים של התוכנית, השורה הראשונה בתמלול היא: שלום לכולם וברוכים הבאים לבואי נדבר רצח פודקאסט על פשע אמיתי מהארץ ומרחבי העולם
. שתי נוסחאות ברכה במשפט אחד, ואחריהן הגדרת התוכנית. כמעט אותה שורה פותחת 29 מתוך 32 התמלולים של התוכנית במאגר, וזו בדיוק המשמעות של פורמולה.
52 מילים עד שנאמר משהו מסוים
הברכה היא רק ההתחלה. השאלה המעניינת יותר היא כמה זמן עובר עד שהפרק אומר משהו שאפשר לתפוס בו. הגדרנו את זה בצורה מדידה, בלי לנחש: מפרקים את התמלול למילים מהתו הראשון, הולכים על 400 המילים הראשונות, ועוצרים במילה הראשונה שמכילה ספרה, או בצמד המילים הראשון שהוא שם מלא מתוך מילון שמות שבנינו מהמאגר. המילה הזאת היא הסימן המסוים הראשון בפרק.
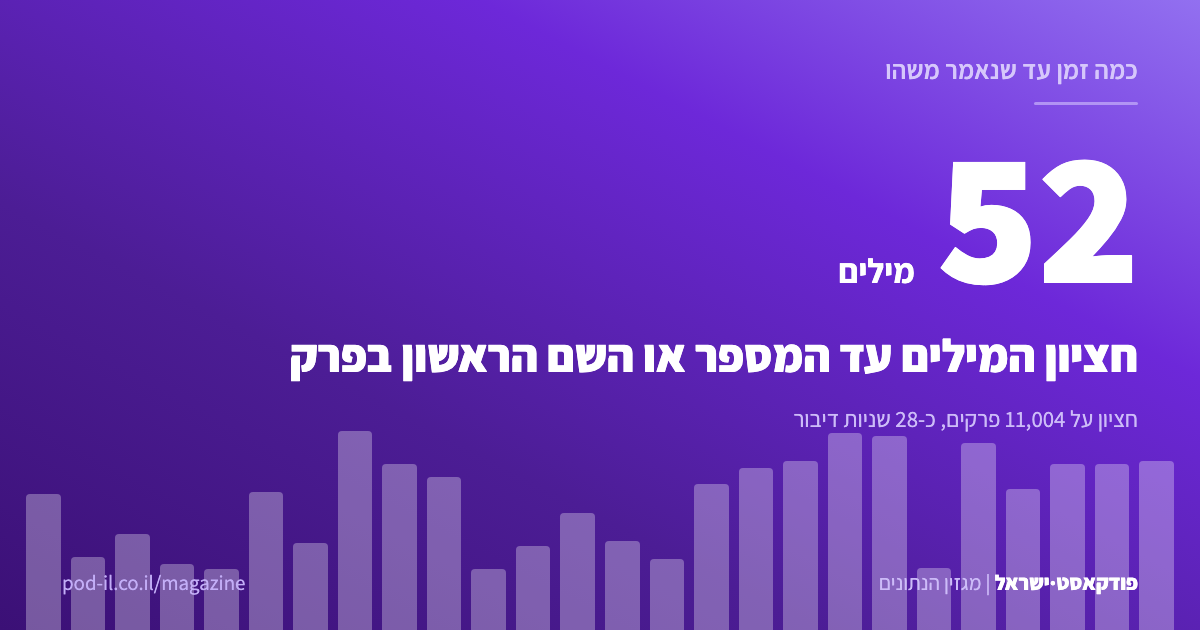
החציון הוא 52 מילים, על 11,004 פרקים שבהם נמצא סימן כזה בתוך 400 המילים הראשונות. ב-4,090 פרקים נוספים, 27.1% מהקורפוס, לא נמצא שום סימן מסוים גם אחרי 400 מילים, והם לא נכללים בחציון. קצב הדיבור החציוני שמדדנו על 9,603 פרקים עם נתוני אורך הוא 128 מילים בדקה, ובזמן זה חציון של 28 שניות, על 7,145 פרקים שיש להם גם קצב מדוד וגם סימן מסוים.
אפשר גם אחרת, וזה נשמע מיד. השורה השנייה בתמלול של פרק 2 של כאן זה לא אירופה, מבית כאן, היא: בשנת 1979, אחרי שישראל זכתה בפעם השנייה ברצף באירוויזיון,
. שנה, אירוע וטענה, והמספר 1979 הוא המילה השישית בתמלול. אף אחת מעשר נוסחאות הברכה לא מופיעה שם.
הפער הזה הוא כל הסיפור. בפרק החציוני עוברות כ-28 שניות עד הפרט המסוים הראשון. בפרק שבנוי אחרת, הפרט הזה מגיע כבר במילה השישית.
רק 24.4% מהפרקים אומרים את שם התוכנית
אם הברכה קיימת כדי לקלוט מאזין חדש, היינו מצפים שהיא תגיד לו לאן הגיע. בדקנו: לקחנו את שם התוכנית מתוך המאגר, ניקינו ממנו סימני פיסוק, וחיפשנו אותו במדויק ב-1,000 התווים הראשונים של הפרק. 2,912 מתוך 11,933 פרקים אמרו את שם התוכנית שלהם, שהם 24.4%.
המספר הזה דורש הסתייגות אחת, והיא חשובה. 2,985 פרקים נוספים אינם ניתנים לבדיקה, כי שם התוכנית שלהם מכיל אות לטינית או ספרה, ותמלול עברי לא יחזיר אותה באותה צורה. הוצאנו אותם מהמכנה לגמרי, ולא ניחשנו עבורם. בנוסף, הבדיקה דורשת את השם המלא, ולכן תוכנית שאומרת גרסה מקוצרת של שמה נספרת כמי שלא אמרה אותו. 24.4% הוא רצפה, לא תקרה.
יש מי שעושה את זה כמו שצריך. פרק 198 של Investcast, תוכנית שבפיד שלה רשומים 192 פרקים, נפתח בשתי שורות שאומרות הכל: ברוכים הבאים לאינבסטקאסט,
ומיד אחריה פודקאסט השקעות ונדל"ן בהנחיית פלג דוידוביץ' ואביב גרינברג.
שם התוכנית, הנושא והמנחים, כבר בשתי השורות הראשונות. מי שהגיע לשם מחיפוש על נדל"ן ודיור יודע בדיוק היכן הוא נמצא.
הז'אנר מזיז הרבה, גודל התוכנית מעט
כאן הנתונים נעשים חדים. פיצלנו את הקורפוס לפי הז'אנר שהתוכנית הצהירה עליו, והשארנו רק ז'אנרים עם 30 פרקים ומעלה: 62 ז'אנרים, 14,395 פרקים. הפער בין הקצוות הוא 61.1 נקודות אחוז.
בחרו ז'אנר וראו את תמהיל הפתיחה שלו
62 ז'אנרים עם 30 פרקים ומעלה, 14,395 פרקים בסך הכל. ז'אנרים קטנים מזה הושמטו.
| ז'אנר | פרקים | עם ברכה | שיעור |
|---|---|---|---|
| אמנות חזותית | 36 | 27 | 75.0% |
| פשע אמיתי | 103 | 73 | 70.9% |
| מקומות וטיולים | 52 | 35 | 67.3% |
| ביקורת קולנוע | 51 | 34 | 66.7% |
| כושר | 41 | 26 | 63.4% |
| תזונה | 76 | 47 | 61.8% |
| עיצוב | 60 | 37 | 61.7% |
| מדע | 319 | 93 | 29.2% |
| חדשות בידור | 99 | 28 | 28.3% |
| אמנויות הבמה | 37 | 9 | 24.3% |
| קורסים | 105 | 24 | 22.9% |
| פנאי | 72 | 15 | 20.8% |
| חדשות יומיות | 239 | 39 | 16.3% |
| סיפורים לילדים | 173 | 24 | 13.9% |
מקור: scripts/mag_israeli-podcast-openings.py, סעיף 5, itunes_genre מתוך data/podcasts.json
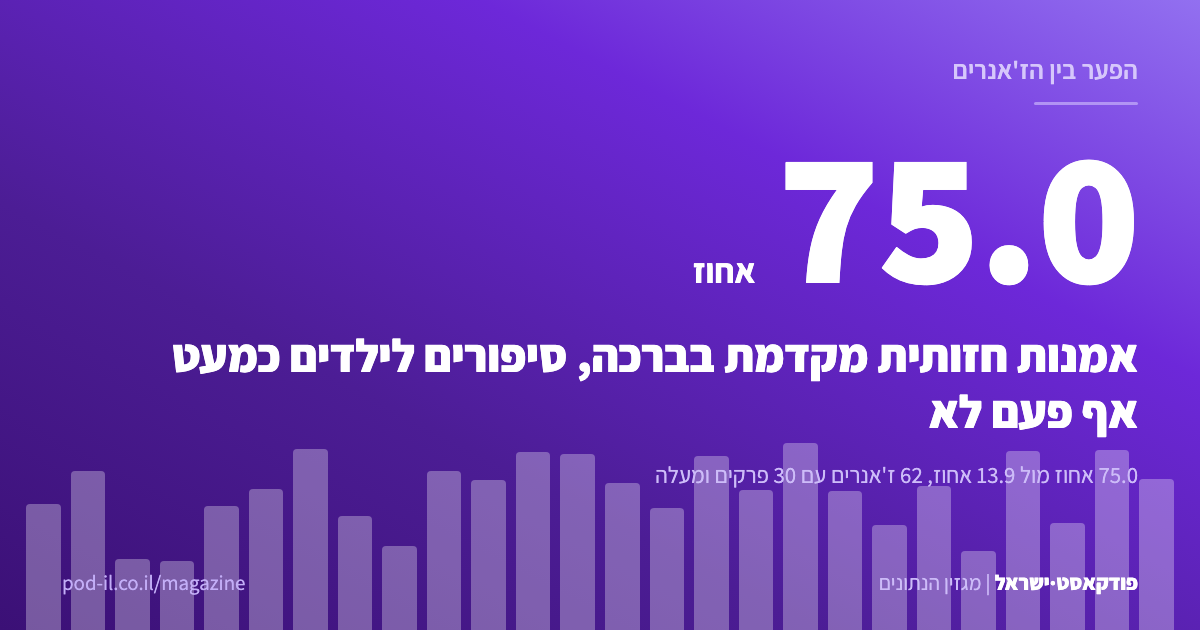
בראש: אמנות חזותית 75.0% (N = 36), פשע אמיתי 70.9% (N = 103), מקומות וטיולים 67.3% (N = 52), שיווק 61.0% (N = 241), כדורגל 60.2% (N = 548). בתחתית: סיפורים לילדים 13.9% (N = 173), חדשות יומיות 16.3% (N = 239), פנאי 20.8% (N = 72), קורסים 22.9% (N = 105), מדע 29.2% (N = 319).
בתחתית הרשימה: סיפורים לילדים, חדשות יומיות וקורסים. בראש: אמנות חזותית, פשע אמיתי וביקורת קולנוע. למה זה כך, הנתונים כאן לא אומרים. הם מראים רק שהפער בין הז'אנרים, 61.1 נקודות, גדול בהרבה מהפער בין רצועות הגודל, 7.2 נקודות.
ואז מגיעה התוצאה השלילית, וגם היא ממצא. חילקנו את הפרקים לפי מספר הפרקים האמיתי של התוכנית בפיד, ולא לפי מה שמופיע בעמוד שלה באתר, וכמעט לא קרה כלום:
| מספר פרקים בתוכנית | פרקים שנבדקו | עם ברכה | שיעור |
|---|---|---|---|
| 1-9 | 2,554 | 1,205 | 47.2% |
| 10-49 | 3,876 | 1,846 | 47.6% |
| 50-99 | 2,247 | 1,049 | 46.7% |
| 100-499 | 4,240 | 1,713 | 40.4% |
| 500 ומעלה | 2,001 | 858 | 42.9% |
הפער בין הרצועה הגבוהה לנמוכה הוא 7.2 נקודות אחוז, על אלפי פרקים בכל רצועה. התוכניות הגדולות, 100 פרקים ומעלה, מברכות קצת פחות, אבל זה פער של נקודות בודדות לעומת 61.1 נקודות בין קצוות הז'אנרים. גודל התוכנית כמעט לא מזיז את הרגל הפתיחה. הז'אנר מזיז אותו הרבה יותר.
הפתיחה, ומי לא שומע אותה
אפשר לסדר את הממצאים כרצף להמחשה, בסדר שבו מאזין עשוי לשמוע אותם. מנוע חיפוש שסורק טקסט לא שומע ממנו כלום, אלא אם הפרק תומלל.
הפתיחה של פרק, שלב אחרי שלב
רצף להמחשה, ולא כל פרק עובר בכל השלבים: ארבעה שלבים בצד המאזין, ושלב חמישי בצד מנוע החיפוש. הקליקו על כל שלב כדי לפתוח ולסגור אותו.
-
כאן הפרק עדיין לא אמר כלום. 44.7% מהפרקים, 6,744 מתוך 15,094, כוללים ברכה מדוברת ב-1,000 התווים הראשונים.
-
אחת מעשר נוסחאות. הנפוצה היא ברוכים הבאים, ב-3,759 פרקים, שהם 24.9% מהקורפוס. הברכה עצמה לא מוסרת שום פרט על הפרק.
-
חציון של 52 מילים עובר עד המספר או השם המלא הראשון בפרק, N = 11,004. בזמן זה חציון של 28 שניות, N = 7,145, ובקצב הדיבור החציוני שמדדנו, 128 מילים בדקה. ב-27.1% מהפרקים לא נאמר שום סימן מסוים גם אחרי 400 מילים.
-
רק 24.4% מהפרקים אומרים בפתיחה את שם התוכנית המלא, 2,912 מתוך 11,933 פרקים שאפשר לבדוק. בשאר, השם המלא לא זוהה בחלון שנבדק, אם כי ייתכן שנאמר שם מקוצר או פרט מזהה אחר.
-
קובץ אודיו אינו טקסט. כל עוד הפרק לא תומלל, מה שנאמר בו לא זמין כטקסט לגוגל ולמנועי הבינה המלאכותית, מלבד מה שנכתב בתיאור הפרק.
זו הנקודה שקל לפספס. אפשר להתווכח על טעם בשאלה אם ברכה היא פתיחה טובה, וזה ויכוח לגיטימי. מה שלא תלוי בטעם: מנוע חיפוש קורא טקסט, ו-6,744 הברכות האלה, יחד עם כל מה שנאמר אחריהן, הפכו כאן לטקסט שאפשר למדוד ולחפש בזכות התמלול. בלי תמלול, רק מי שכבר לחץ פליי שומע את הפתיחה.
מה זה אומר ליוצרים
שתי מסקנות מעשיות, ושתיהן נובעות ישירות מהמספרים. הראשונה: אם אתם רוצים שמאזין חדש יידע איפה הוא נמצא, תנו לברכה לעשות עבודה. רק 24.4% אומרים את שם התוכנית, כך שעצם אמירת השם כבר מבדלת אתכם. השנייה: בחציון עוברות 52 מילים עד הפרט המסוים הראשון, וכדאי לקצר את הדרך אליו, עם מספר, שם או תאריך.
מעבר לזה יש בעיה שאי אפשר לפתור בתוך האודיו. האודיו עצמו אינו קריא לגוגל ולמנועי הבינה המלאכותית, כי אין בו טקסט. ההמלצה שלנו: הדרך הישירה להפוך את הפתיחה הזאת לניתנת לחיפוש ולציטוט היא להפוך כל פרק לעמוד כתוב. בדיוק את זה עשינו כאן: הכתבה הזאת נשענת על 15,094 פרקים שתומללו ונותחו אוטומטית. כך זה עובד על ארכיון שלם.
שאלות ותשובות
איך נפתחים הפרקים של פודקאסטים ישראליים? 44.7% מהפרקים, 6,744 מתוך 15,094, כוללים אחת מעשר נוסחאות ברכה מדוברות בתוך 1,000 התווים הראשונים. הנפוצה ביותר היא ברוכים הבאים, ב-3,759 פרקים.
כמה זמן עובר עד שפרק אומר משהו מסוים? חציון של 52 מילים, N = 11,004, ובזמן חציון של 28 שניות, N = 7,145. ב-27.1% מהפרקים לא נאמר מספר או שם מלא גם אחרי 400 מילים.
איזה ז'אנר הכי מברך? אמנות חזותית, 75.0%, N = 36, ואחריה פשע אמיתי, 70.9%, N = 103. בתחתית סיפורים לילדים, 13.9%, N = 173. הפער בין הקצוות הוא 61.1 נקודות אחוז.
האם תוכניות עם הרבה פרקים מברכות יותר? לא, אפילו קצת פחות: 42.9% בתוכניות עם 500 פרקים ומעלה, מול 47.2% בתוכניות עם עד תשעה פרקים. הפער בין הרצועה הגבוהה לנמוכה הוא 7.2 נקודות, לעומת 61.1 בין קצוות הז'אנרים.
למה זה בכלל משנה לקידום? כי מנוע חיפוש קורא טקסט ולא שומע אודיו. 6,744 הברכות האלה, ומה שנאמר אחריהן, נעשו בקורפוס הזה טקסט שאפשר למדוד ולחפש רק אחרי שהפרקים תומללו.
האם הממצא תלוי בגודל החלון שנבדק? רק במידה מתונה. ב-600 התווים הראשונים השיעור הוא 40.5%, ב-1,000 הוא 44.7%, וב-1,500 הוא 47.0%. הגדלת החלון פי 2.5 מזיזה את הממצא ב-6.5 נקודות בלבד.
הכתבה נכתבה בסיוע בינה מלאכותית על בסיס ניתוח הקורפוס של פודקאסט·ישראל. כל המספרים חושבו מחדש ב-11 באוקטובר 2026 מ-15,094 התמלולים הקנוניים ומ-3,534 התוכניות באינדקס, וניתנים לשחזור מלא על ידי הרצת scripts/mag_israeli-podcast-openings.py משורש המאגר. מילון השמות שמשמש לאיתור השם המלא הראשון בפרק נגזר מניתוחים אוטומטיים של התמלולים, ולכן החלק הזה של המדידה יורש את אותה מגבלה. שברי שורות בתמלול מוצגים בציטוטים כרווח.